Article by: Trevor Elkins(読了時間:4分)
毎朝、チームの誰かがダッシュボードを見るよりも前に、Claude Routine はすでに前夜の会話を約800件、Seer(Sentry のエラーをトリアージして修正する AI エージェント)から読み込んでいます。おかしそうな会話にフラグを立て、新しく見つかったものについてはチケットを起票します。私たちがコーヒーを片手に席に着くころには、トリアージはほとんど終わっています。
課題
このルーティンが存在する前は、エージェントの挙動を確認するには、現在の eval システムからデータを取り出すための、場当たり的で使い捨てのフローが必要でした。クエリの選択肢は限られていたため、その大半は各 trace の生の JSON を解析するパーサーを自前で用意することに帰着していました。誰かが分析を実行することを覚えておき、手動でやらなければなりませんでした。自動化するという選択肢もありましたが、手間がかかるため結局着手できずにいました。さらに、私たちはこのデータを日々使っている他のツールにも送りたいと考えていましたが、当時の構成にはそうした連携性がありませんでした。
私たちが探していたのは、さまざまなものが入り混じったものでした。tool call の失敗、hallucination による出力、レイテンシのスパイク、必要以上に長く続いてしまうエージェントのループ、コストの異常。要するに、全部です。
主な目標は3つ。tool error を減らすことで信頼性を高めること、異常な実行のロングテール(通常より極端にコストがかかったり、一般的な会話よりはるかに多くの tool call を行ったもの)に目を配ること、良さそうに見える会話をサンプリングして、良いと決めつけるのではなく実際に良いことを確認することです。
Claude Routine
このルーティンは Claude Routine として毎朝実行されます。Sentry MCP(Claude が Sentry に直接クエリを実行できるようにする Model Context Protocol server)を介して接続し、前夜の会話に対して Agent Tracing のクエリと、いくつかの一般的なクエリを実行します。
各実行は同じ手順を踏みます。
1. 期間の集計統計を取得する。つまり、夜間にどれだけの会話が実行されたか。
2. tool の集計統計を取得する。つまり、いくつの tool でエラーが発生し、その割合はどれくらいか。
3. エラーが発生した tool のリストから、いくつかの span をサンプリングし、失敗の背後にある実例と傾向を確認する。
4. tool error のあるものとないものを織り交ぜて会話全体をサンプリングし、エージェントの最終的な verdict が実際にその reasoning と一致しているかを判断する。
5. さらなるコンテキストのために、Seer のコードベース自体を取り込む。
6. それらすべてを、新しい発見をまとめた1つのレポートにまとめる。
7. 既存のチケットがないか Linear プロジェクトを検索し、まだ追跡されていないものについてのみ新規に起票する。
その背後にあるプロンプトは、作業と判断の大半を LLM に任せるために、あえてシンプルにしてあります。このルーティンは Sentry MCP を通じて Sentry に直接クエリを実行するため、追加でセットアップするツールはありません。必要なのはそれだけです。
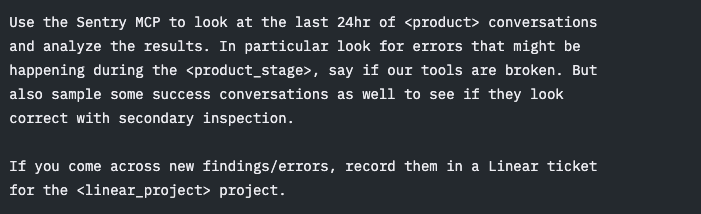
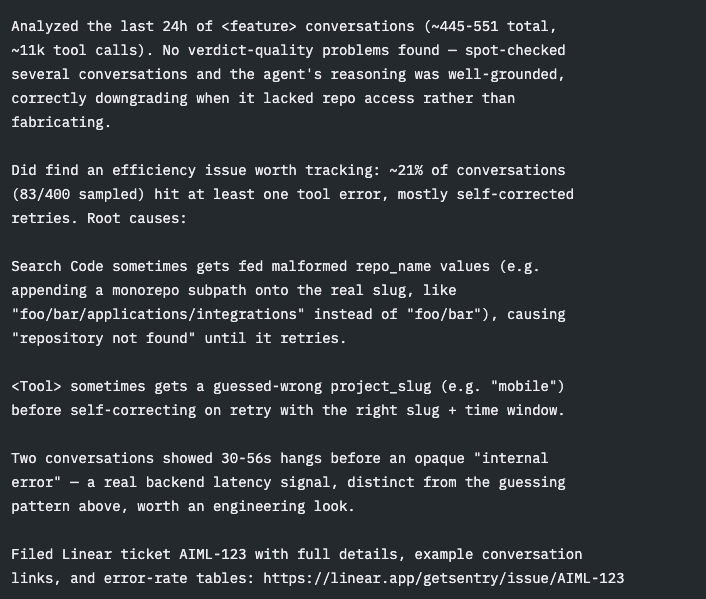
上記の repo の hallucination のケースは、フラグが立つ典型的な朝がどのようなものかを示す良い例です。このルーティンの tool error 統計が、その期間において Search Code のエラー率が突出していることを浮かび上がらせました。背後にある span をいくつかサンプリングしてみると、毎回同じ形が見えてきました。エージェントが repo 名を次々と推測しては、どれも当たらない、という状態です。会話全体を引き出してみても、毎回同じことが起きていました。エージェントは、自分がどの repo を探しているのか全く分かっていなかったのです。
集計されたエラー率だけでは、これは見えてきません。会話を1件ずつ読むだけでも同様です。その両方があって初めて分かったのです。そして一度それが見えてしまえば、修正は単純でした。エージェントに推測させるのではなく、repo 名をそのまま渡すだけです。
学んだこと
これを毎日実行することで、フィードバックループが十分に速くなり、ほとんどの修正は問題を見つけたその日のうちに反映できるようになりました。
ベストプラクティスをいくつか挙げるなら、次のとおりです。
1. tool error のあるものだけでなく、成功した会話と失敗した会話の両方をサンプリングすることは、想定以上に重要でした。会話は tool error が1つもなくても完了し、それでいて誤った結論にたどり着くことがあります。それは reasoning を verdict と照らし合わせて何か(あるいは誰か)が確認して初めて明らかになるものです。
2. プロンプトをデータ取得ではなく判断に集中させ続けることで、出力は日々はるかに一貫したものになりました。クエリの実行は Sentry MCP が担うため、このルーティンは毎回 trace のクエリロジックを一から組み立て直す必要がありません。
自分で試すには
Claude Routines を使えば、とても簡単にできます。まず、お使いのエージェントで Agent Tracing がセットアップされていることを確認します。次に Sentry MCP を使って、あなたの機能に関するエージェント trace を探すよう指示し、私のものと同様のプロンプトを持つ Claude Routine を追加します。最後に、Sentry MCP Connector(および Linear などの他のもの)がルーティンに対して設定・有効化され、Sentry に正しく認証できるようにします。
以上です! 詳しい手順については、ステップバイステップのレシピをご覧ください。
Original Page: Automated agent triage with Agent Tracing and Claude Routines
IchizokuはSentryと提携し、日本でSentry製品の導入支援、テクニカルサポート、ベストプラクティスの共有を行なっています。Ichizokuが提供するSentryの日本語サイトについてはこちらをご覧ください。またご導入についての相談は「お問い合わせ」からお気軽にお問い合わせください。