Article by: (読了時間:11分)
トラフィックの急増を乗り切るためのアドバイスは、ほとんどがキャパシティに関するものです。フリートをスケールし、キャッシュをウォームアップし、チェックアウト経路の負荷テストを行う。どれも、何かが壊れたら見つけた瞬間に修正できることが前提です。
モバイルアプリはそうはいきません。先日、Jay Henryとのワークショップで1時間ほどお話しする機会がありました。JayはEtsyのシニアエンジニアリングマネージャーで、CI、ビルド、テスト、リリース、オブザーブ、SREを担う3つのチームのエンジニアリング戦略を統括しています。Jayによれば、Webチームなら調子の悪い日でも数分でリバートできます。デバッグは必要ですが、その時点で問題のコードはすでに本番から外れています。
モバイルにはリバートがありません。バイナリに含まれた状態でバグがリリースされると、発見、根本原因分析、再現、設計、テスト、マージ、申請、App Storeの審査、ロールアウトという全行程をたどらなければなりません。ユーザーが修正版をいつインストールするか、そもそもインストールするかはコントロールできず、インストールされなければ壊れたバージョンが動き続けます。
そのため、Etsyのホリデーシーズンへの備えはキャパシティの話ではありません。リバートという選択肢がない11月に、何を把握し、どう振り分け、どう緩和できるかを、10月のうちに決めておくことなのです。
ここでは対談のハイライトをいくつか紹介します。その多くはECに限った話ではありません。
Etsyはコードフリーズではなくコードスラッシュを採用
コードフリーズは完全な停止です。一定期間、変更のマージやリリースを止めます。大雑把な手段ですが効果はあるため、多くのチームが採用しています。
Etsyは代わりにスラッシュを運用しています。入れ子になった3つのフェーズがあり、段階が進むごとにリリースのハードルが上がっていきます。
- フェーズ1 — 10月中旬、出品者がホリデー向けの在庫を準備する時期に始まります。エンジニアへのガイダンスは「慎重にマージすること」で、具体的な判断基準は、その変更によって出品者が一番忙しい時期にビジネスの新しい運用方法を覚えなければならなくなるかどうかです。そうなる場合は、ホリデー明けまで待ちます。
- フェーズ2 — インフラ強化の期間です。変更がインフラに負荷をかけてはならず、負荷の増加を伴う実験はまずスケーラビリティチームの確認を経ます。
- フェーズ3 — ピーク期で、おおむね感謝祭からサイバーウィークまでです。かなり上の立場の承認がなければ何もリリースせず、Jayの言葉を借りれば、リリースするのは改善のためのものだけです。
どんな変更なら許可されるか、というリストがあるわけではありません。その代わりにシニアの承認という関門があり、承認がなければ何も進みません。判断ミスのコストが最も大きくなる時期には、ルールではなく人が判断するということです。
スラッシュから一つだけ取り入れるなら、この仕組みがおすすめです。ただしその場合は、誰が判断するのか、何を基準に判断するのかもあわせて決めておく必要があります。この2つが決まっていて初めて、「シニアの承認を得る」というルールが機能します。
「シニアの承認を得る」が通用しない場合は、判断基準をいくつかの質問として順番に書き出しておきましょう。そうすれば、ほとんどの変更は承認者を必要としなくなります。
- 今まさにユーザーがこの問題に遭遇しているか。そうでなければ待つ。
- リリースせずに止められるか。フラグをオフにしたり設定値を変えたりして対応できるなら、そちらを選ぶ。最速の修正は、アプリ審査を経ずに済むものです。
- リリースが必要な場合、1ステップで元に戻せるか。取り消せない変更と取り消せる変更とでは、議論の性質がまったく異なります。
- チェックアウト、認証、決済に関わるか。差分がどれだけ小さく見えても、指定された承認者に回します。
こうした質問があれば、高負荷の中で特定の変更について議論するときも、本来のルールが何だったかではなく、その変更そのものについて議論できます。
フリーズでは議論の対象が一つの日付だけになります。スケジュールに沿ってハードルが上がる仕組みなら、エンジニアは6週間前の時点で目の前の変更にルールを当てはめられます。リスクの高いマージが行われるのは、まさにその時期です。
ピーク期にエンジニアへ新しいツールを渡さない
Etsyは2025年にモバイルアプリをSentryに移行し、その作業はスラッシュの直前に完了しました。それでも、旧ツールは稼働させたままにしました。
Androidではプロバイダーリスト、iOSではクラッシュレポートレイヤー内の2つの分岐を使ってデュアルレポーターを構成し、どちらかを選ぶのではなく、ホリデー期間中ずっと両方のベンダーにクラッシュを送信し続けました。
「一年で最も不安定な時期に、エンジニアの環境を変えるつもりはありませんでした。」とJayは言います。何かが取り上げられることはなくエンジニアは全員、一年を通して見慣れたツールを使いこなせる状態でピークを迎え、さらに深く掘り下げたいときは新しいツールも使えました。
両方を稼働させたことで、評価だけでは答えられない問いにも答えが出ました。どちらのツールもクラッシュフリー率を報告していました。両者の数値は一致するのでしょうか。一年で最も負荷が高い状況でも一致するのでしょうか。ピーク期が検証の場となり、2026年を迎える頃には、旧プラットフォームを廃止する確信が得られていました。
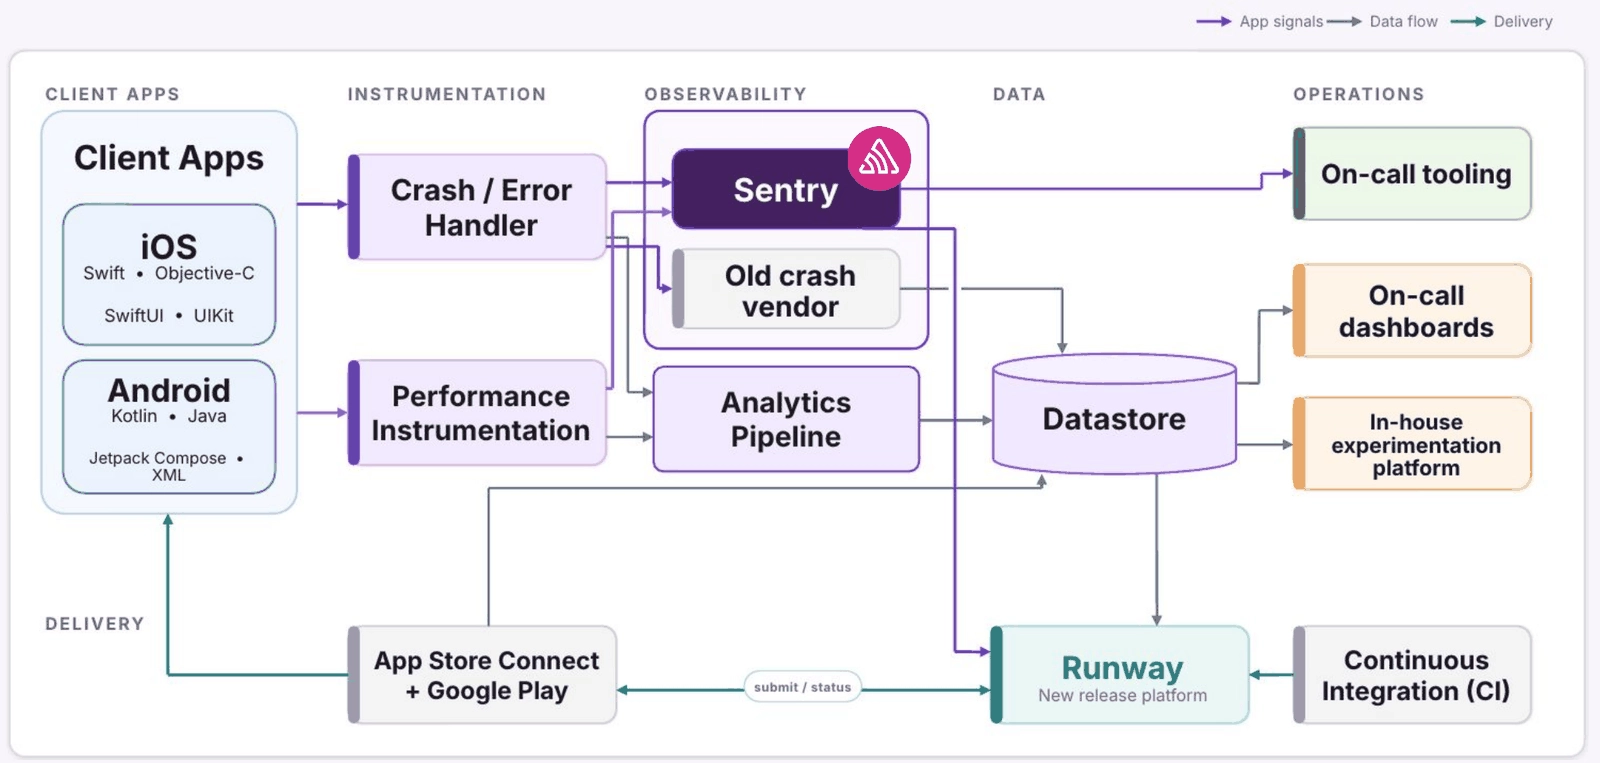
このアイデアはぜひ取り入れてください。2つの送信先に振り分けられるレポートレイヤーがあれば、ベンダーの変更は大規模なプロジェクトではなく、設定変更で済みます。必要になる前に作っておけば、切り替えを決めたときにすぐ実行できます。
どの手段がコードに届くのかを把握する
ユーザーにアップデートを強制することはできません。できるのは、ユーザーに影響を与えている機能をオフにする手段がいくつあるかを事前に決めておくことです。
Etsyには3つのレイヤーがあります。ほとんどの実験は実験用フラグの背後にあるため、アプリがランタイムでクラッシュしていない限り、問題のあるバリアントをオフにできます。実験以外の変更は運用フラグの背後に置きます。そしてまれなケースでは、ユーザーがアップデートするまでアプリを使えなくする強制アップデートのプロンプトを表示できます。ただし、ユーザーにとても嫌われるため、ほとんど使うことはありません。
これらのレイヤーの外にあるものは、旧バージョンが使われ続ける間ずっと付き合っていくしかありません。Jayのたとえでは、アプリのリリースはAOLのディスクを配るようなものです。一度世に出たら、次のディスクが届くまでそのままです。
だからこそ、フラグの監査もこのリストの他の項目と同じく10月に行うべきなのです。クラッシュしやすい機能を一つずつ確認し、アプリをリリースせずに問題のコードパスを無効化できるリモートフラグがあるかをチェックします。コード上にフラグがあっても、壊れたパスがそのフラグを参照していなければ意味がありません。
アラート疲れは、3週目あたりから始まる
Jayが説明した障害パターンは、私自身のチームでも目にしたことがあるもので、なかなか厄介です。通知を無視し始めたと宣言する人はいないからです。
1週目は通知を読みます。2週目は流し読みします。3週目はフィルターを作ります。4週目には誰も読んでおらず、かといって誰も削除してもいません。皆、他の誰かが見ているだろうと思い込んでいます。
新しいツールの導入時は、この状況に陥りやすくなります。デフォルトがメール中心になっていることもあり、まだ優先度によるトリアージもされていないため、すべてが緊急に見える形で届くからです。この時期こそ注意深く観察し、どれがアラートに値し、どれが値しないかを素早く見極めましょう。
Etsyはその逆のやり方をとっています。大きな音で鳴るアラートのトリガーは2つだけです。クラッシュフリー率と、過去の水準から外れた1時間あたりのクラッシュ数です。どちらかが条件を満たすとSlackにアラートが送られ、対応するインシデントが作成されます。
それ以外はすべて別のSlackチャンネルに届きます。そこには、単に捨ててしまいたくはないIssueが流れてきます。誰かを叩き起こすためではなく、増えているものを誰かが確認してチームに振り分けるためのチャンネルです。
ここに2点付け加えます。まず、上限だけでなく下限にもアラートを設定しましょう。Jayがある特定のチェックアウトタイプが減少していることに気づいたのは、たまたま無関係なGrafanaダッシュボードを作っていたからでした。結局は想定どおりの移行によるものでしたが、それを知らせてくれるアラートはありませんでした。沈黙もシグナルですが、ほとんどの人はそれを監視していません。
そして、しきい値は古くなります。ボリュームは変わるので、去年は意味のあった数値も今では意味を持たなくなります。Jay自身はアラートがうるさくなったときに対応するようにしていますが、四半期ごとにリストを見直すことを勧めています。
Issueのグルーピングはコードに沿い、オーナーシップは画面に沿う
Sentryはコード構造に基づいてIssueをグルーピングします。一方、Etsyのオーナーシップはサーフェス、つまり画面や機能、そしてその背後にいるチームを軸に構成されています。この2つは一致せず、ピーク期にはそのズレのせいで何時間も失うことがあります。
実際にこんなことがありました。あるIssueでは、エラーの25%が商品ページ、25%がホームページ、50%がカートで発生していました。どのチームもそれを見て「うちの担当ではない」と、正しく判断しました。誰かが無責任だったわけではありません。単に、データが問題の担当を示していなかったのです。
Etsyはグルーピングを作り直すのではなく、ユーザーが最後にいた画面などのカスタムタグを追加し、Issueにサーフェスのコンテキストを持たせました。そしてIssueを一つずつ確認し、無関係なクラッシュまで取り込んでいたグループを分割するルールを書き、細かく分かれてしまっていたものはマージしました。社内の実験システムはインテグレーションに対応していないため、実験の情報もタグとして追加しています。
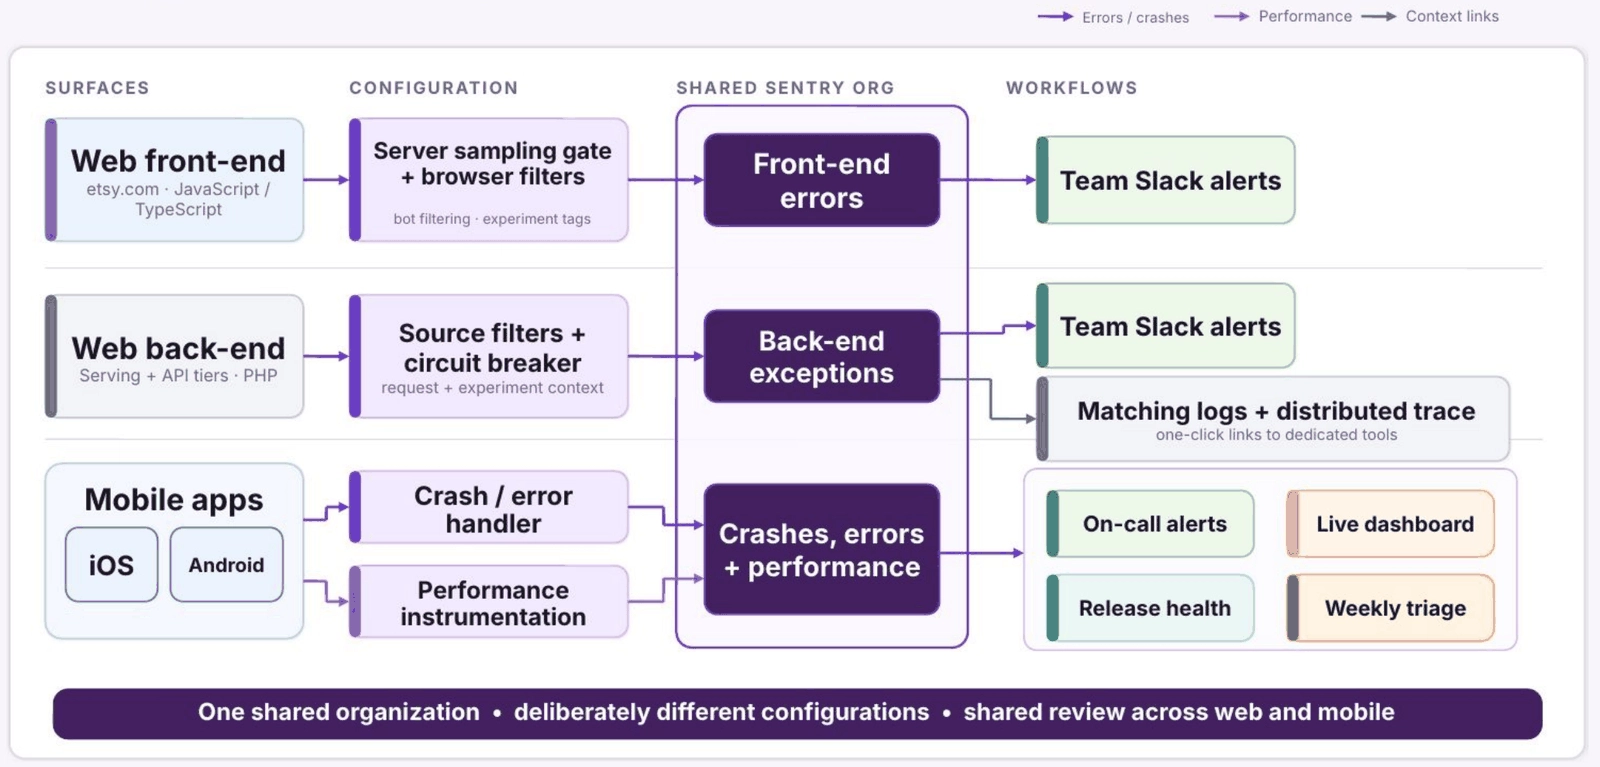
どれも体系的な取り組みではなく、今も進行中です。それでも10月の時点で、「どのチームの担当か」という問いには、Slackのスレッドではなくタグで答えが出るようにしておきたいところです。
エラーの見当がついていても、Issue一覧から始める
何かが急増したとき、Jayはどのエラーを追っているか分かっていても、Issueの一覧から確認し始めます。全体の中で、そのエラーがどのような位置にあるのかを確認したいからです。
診断のほとんどは、各Issueのスパークラインを見るだけで済みます。低いボリュームで長く続いていた線が急に上昇している場合と、すでに減少傾向にあるスパイクとでは、意味合いが異なります。24時間の表示ではパターンが見えないため、Jayはほぼすぐに表示期間を14日または30日に広げます。
彼が確認しているのは、近くのIssueが一斉に増えているかどうかです。もしそうであれば、原因はたいてい一つで、リリースまたは実験のランプアップです。そうなれば、ランプの形状から確認すべき期間が分かり、タグからは疑わしい実験を含むイベントの割合が分かります。原因を修正すれば、複数のIssueをまとめて解決できます。
逆に、通知に促されるままに対応すると、一つのIssueに午後いっぱいを費やし、関連する4つのIssueは放置されたままになってしまいます。
クラッシュをビジネスがすでに使っている言葉で語る
これは、私がずっと考え続けている教訓です。
Jayの以前のCTOは可用性メトリクスに関する月例会議を開いており、他のチームは自分たちの技術的な健全性をビジネスへの影響に直接結びつけることができました。クラッシュにはそうした分かりやすい結びつきがなかったため、プロダクトマネージャーと「クラッシュが起きた、それで?」という会話をするのは難しいものでした。
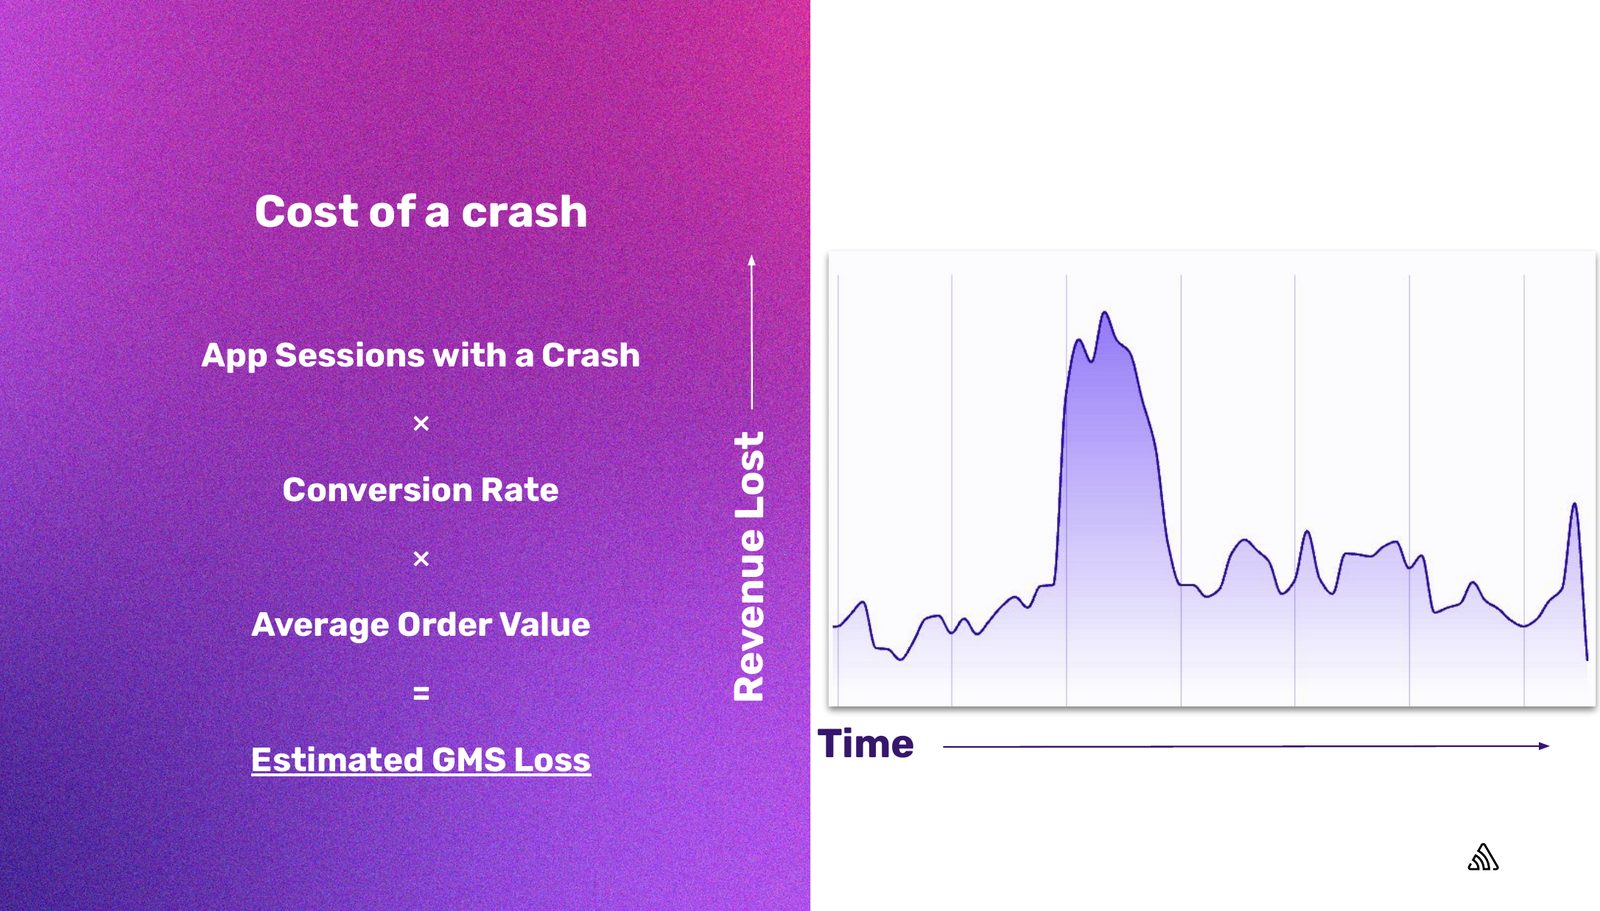
Jayはこれを、Etsyのビジネスアナリストと協力することで解決しました。アナリストはプロダクトチームに組み込まれており、誰も異論を唱えないメトリクスを基準に、年間数千件もの実験を評価しています。そうしてたどり着いた計算式がこちらです。
FAQ
■ コードフリーズとは何ですか?コードスラッシュとはどう違うのですか?
コードフリーズとは、一定期間、変更のマージやリリースを完全に止めることです。通常、トラフィックが多い時期やリスクの高い時期の前に実施します。コードスラッシュは同じ目的を持ちつつ、スイッチを切り替えるように一気に止めるのではなく、段階的にハードルを上げていきます。Etsyでは10月中旬から、入れ子になった3つのフェーズを運用しています。まず「慎重にマージ」、次に「インフラ強化」(インフラに負荷をかける変更は行わず、負荷を増やす実験はスケーラビリティのレビューを経る)、そして「ピーク」です。ピーク期には、かなり上の立場の承認がなければ何もリリースせず、リリースするのは改善のためのものだけです。
■ ピークトラフィック時のアラート疲れはどう防げばよいですか?
人の手を止めさせるアラートのリストは、皆が読み続けられる程度に短く保ち、それ以外は受信箱ではなくチャンネルに送りましょう。短いリストに入れるかどうかの基準は、その状況が誰かを起こす価値があるかどうかです。Etsyでは、クラッシュフリー率と、自社の過去の水準と比較した1時間あたりのクラッシュ数の2つを使っています。それ以外はすべて別のSlackチャンネルに送り、ページングではなくトリアージと振り分けに使います。上限だけでなく下限にもアラートを設定しましょう。メトリクスが静かになることもシグナルだからです。また、トラフィック量は変動するため、しきい値は四半期ごとに見直しましょう。
■ アプリのクラッシュによるビジネスコストはどう測ればよいですか?
Etsyでは、クラッシュが発生したアプリセッション数にコンバージョン率と平均注文額を掛けて、クラッシュによって失われたGMSの推定値を算出しています。すべてのクラッシュが注文の損失につながるわけではないため推定値にすぎませんが、クラッシュ率を社内の他の部門がすでに使っている数値に変換できます。一般的なやり方としては、自社が日頃から使っている2つか3つのメトリクスを見つけ、技術的な健全性をそれらに結びつけることです。
■ モバイルアプリのリリースはロールバックできますか?
Webのデプロイのようにはロールバックできません。バイナリに含まれた状態でバグがリリースされると、修正までの道のりは、発見、根本原因分析、再現、修正そのもの、テスト、マージ、ストアへの申請、App Storeの審査、ロールアウト、そしてユーザーがインストールを選ぶところまで続きます。できるのは、どの緩和手段がコードに届くかを事前に決めておくことです。実験フラグ、運用フラグ、そしてまれに強制アップデートのプロンプトです。
Original Page: How Etsy gets its mobile apps ready for peak traffic
IchizokuはSentryと提携し、日本でSentry製品の導入支援、テクニカルサポート、ベストプラクティスの共有を行なっています。Ichizokuが提供するSentryの日本語サイトについてはこちらをご覧ください。またご導入についての相談は「お問い合わせ」からお気軽にお問い合わせください。