Article by: Kyle Tryon(読了時間:12分)
要約: ログはデバッグのため、メトリクスは分析のためのものです。何かが起きた時点の状態をログに残しておけば、後からその状況を再現できます。何も問題が起きていないときでも継続的に追っていきたい数値があるなら、それはメトリクスにしましょう。
SentryにLogsとApplication Metricsが加わったことで、アプリ内で何かが起きたことを記録する方法が2つになりました。しかもこの2つは、Sentry.logger.info("user.signup") と Sentry.metrics.count("user.signup") のように、見た目もかなり似ています。
どちらも属性を保存でき、共有コンテキストを自動的に含んでいて、フィルタリング・グループ化・カウントが可能です。
では、コードをインストルメントするとき、どちらを使えばいいのでしょうか。【エラー・トレース・ログ・メトリクス】いつ何を使うかを読んだ方なら、このテーマを以前にも取り上げたことをご存じでしょう。中でもログとメトリクスは特に迷いやすい組み合わせですが、サインアップフローが1つあれば、どちらをいつ使うべきかを十分に示せます。
ログ、メトリクス、トレース、どれを使う?
サインアップハンドラーを書いているとしましょう。ユーザーがフォームに入力して送信ボタンを押します。このイベントについて、何を知りたいでしょうか。
- 誰がサインアップしたか
- どのようにサインアップしたか(どの方法で、どのプランか)
- 成功したか、失敗したならその理由は何か
- どれくらい時間がかかり、どこに時間を費やしたか
いずれ答えを知りたくなる問いがもう1つあります。
サインアップ数が増えているのか減っているのか、です。ただしこれは種類の異なる問いなので、後ほど改めて取り上げます。
上記4つのうち1つは、トレーシングを有効にしておくだけで自動的に得られます。
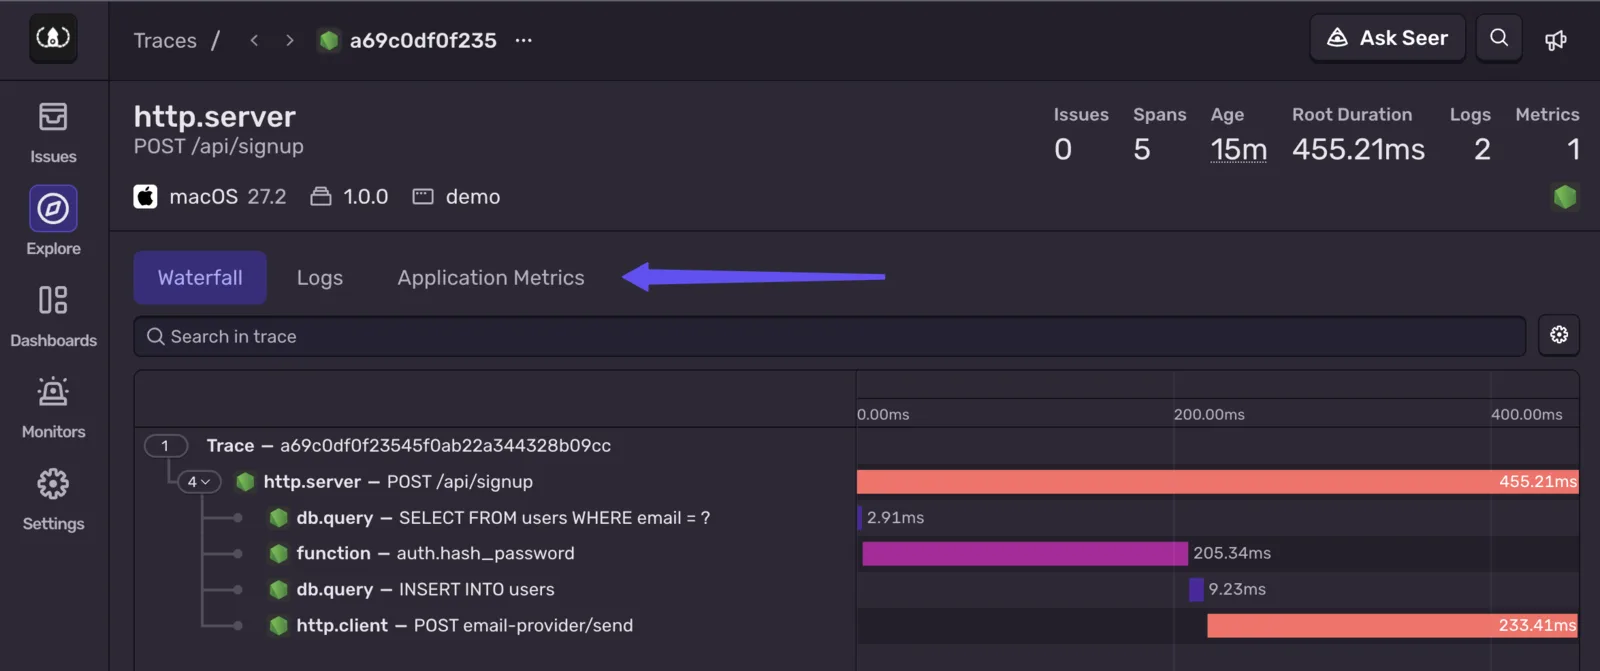
このトレースからは、サインアップが行われたこと、かかった時間、そしてどこに時間がかかったかがわかります。リクエストのほぼ半分はメールプロバイダーの処理で、残りの大部分はパスワードのハッシュ化です。これを知るために、コードに何かを追加する必要はありませんでした。
また、トレースはエラー、ログ、メトリクスを発生元のリクエストと紐づけるので、1件のサインアップに関する情報がすべて1か所にまとまって表示されます。
ただし、トレースはサンプリングされます。遅いリクエストをデバッグするために、すべてのサインアップリクエストが必要なわけではありません。どこに時間がかかっているかを把握できるだけあれば十分なので、ノイズとコストを抑えるために大半は破棄されます。Sentryは保持したトレースから外挿するため、近い値は得られますが、正確な件数にはなりません。
なお、ログとメトリクスはサンプリングされません。SDK(software development kit)でフィルタリングすることはできますが、送信したものはすべて保持されるので、いざというときに頼りにできます。
トレースが答えてくれたのは「どれくらい時間がかかったか」です。誰が、どのようにサインアップしたか、そして成功したかどうかは、自分で記録する必要があります。
このサインアップを説明し、送信するすべてのデータに当てはまる属性がいくつかあります。毎回の呼び出しで繰り返す代わりに、スコープ上に共有属性として設定すれば(SDK v10.61.0以降で利用可能)、自動的に適用されます。
サインアップ方法とユーザーのプランはリクエストが届いた時点でわかるので、ハンドラーの冒頭で設定しましょう。こうしておけば、サインアップが失敗した場合でもこれらの属性が含まれます。

ユーザーが作成されたら、そのユーザーも追加します。
以降、そのスコープ内で送信されるもの(エラー、ログ、そしてメトリクス)にはすべて user.id が付与されます。
ログに残すか、カウントするか
このコンテキストを設定しておけば、ログとメトリクスは何が起きたかを記録するだけで済みます。
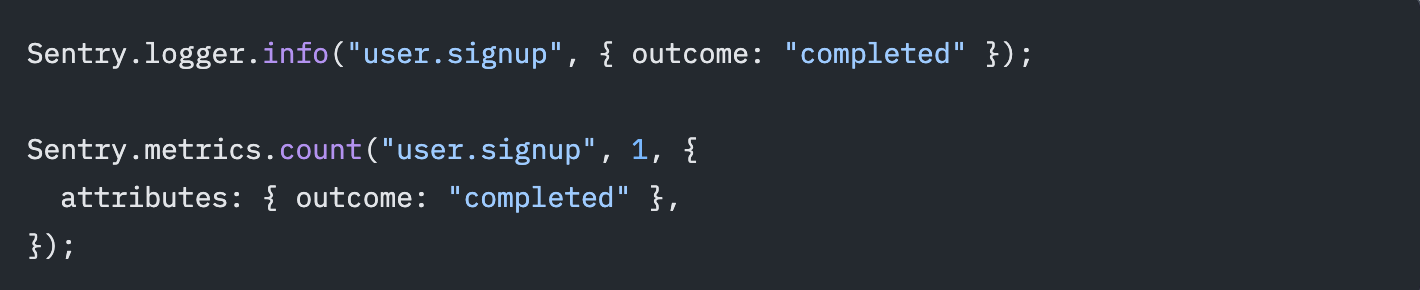
ログには重要度(ここでは info)があり、これは実質的には属性の1つにすぎません。そして、任意の文字列を指定できるメッセージがあります。
Counterには、ログのメッセージと同じ役割を果たす名前と、どれだけ加算するかを示す数値があります。
では、なぜ両方あるのでしょうか。どちらを使ってもサインアップの正確な件数がわかるので、一見同じ役割を果たしているように見えます。
違いを生むのは、何を問うかです。
ログが答える問い
このユーザーに何が起きたのか
あるユーザーからサポートにメールが届きます。「メールアドレスでサインアップしたのに、確認メールが届きません」。
このユーザーのログを見たいところです。サインアップフローでは、ログにはすでにスコープ由来の user.id、サインアップ方法、プランが含まれています。
しかし現状のままでは、サインアップのログには確認メールについての情報がありません。確認メールの送信はそれ自体に結果を持つ別のイベントなので、専用のログを用意しましょう。
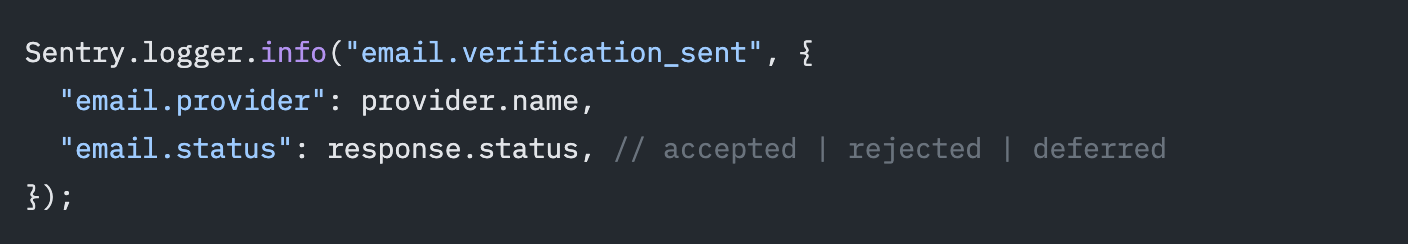
どちらのログも同じトレースに紐づいているので、サインアップのトレースには両方がまとめて表示されます。
ログ側から始めて、user.id でフィルタリングすることもできます。探していたメールのステータスがそこに表示され、トレースへのリンクも付いています。
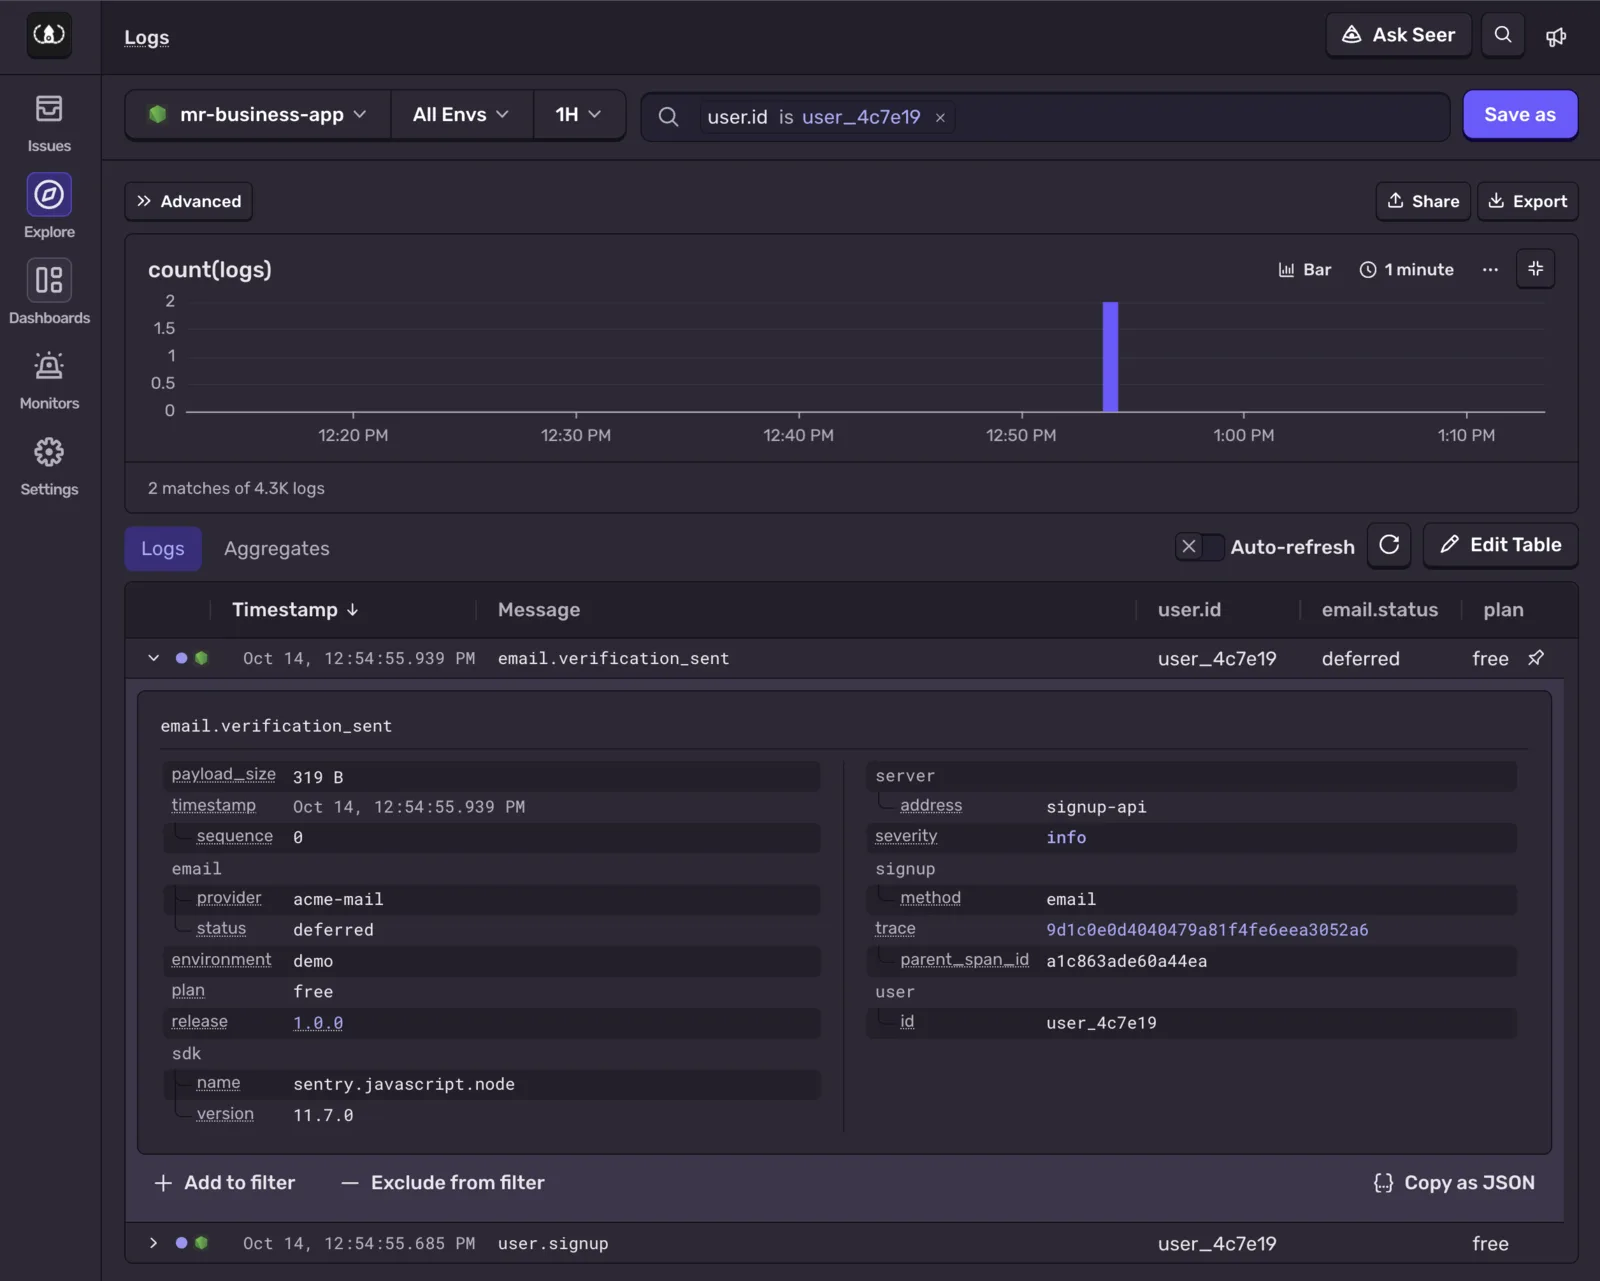
トレースからもこれらすべてがわかったはずですが、トレースはサンプリングされるので、このユーザーのトレースはおそらく破棄されています。一方、ログは残っています。
サインアップが失敗するのはなぜか
今朝のリリース後、何人かのユーザーから、サインアップフォームから先に進めないという報告が寄せられました。
サインアップを試みるたびに、成功・失敗にかかわらず、同じ user.signup ログが1回書き込まれます。失敗した場合は outcome: "failed"、warn レベル、そして理由が付きます。この時点ではまだユーザーは存在しませんが、signup.method と plan はすでにスコープに設定されています。
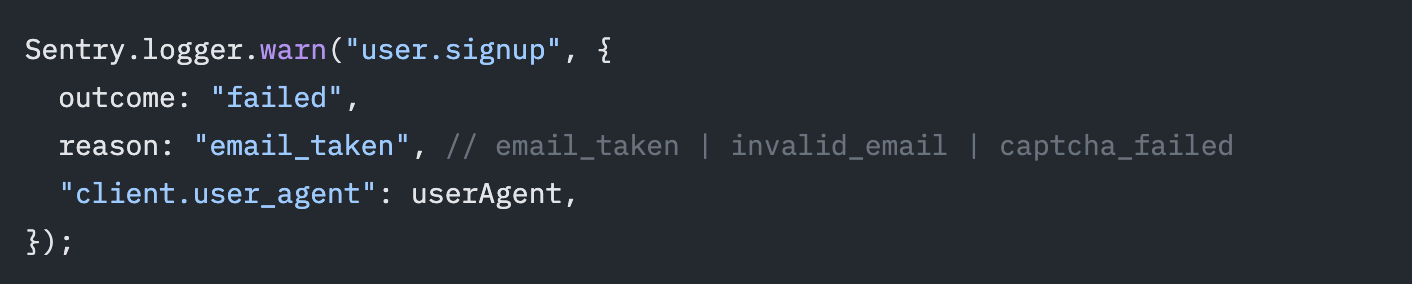
ここは判断が分かれるところです。普段なら、失敗したサインアップをカウントするメトリクスを作成するところです。ただし、このログ行が必ず出力されるのであれば、代わりにログをカウントすることもできます。
reason でグループ化して時系列でグラフにすれば、リリース後の captcha_failed の急増も、Counterと同じくらいはっきりわかります。
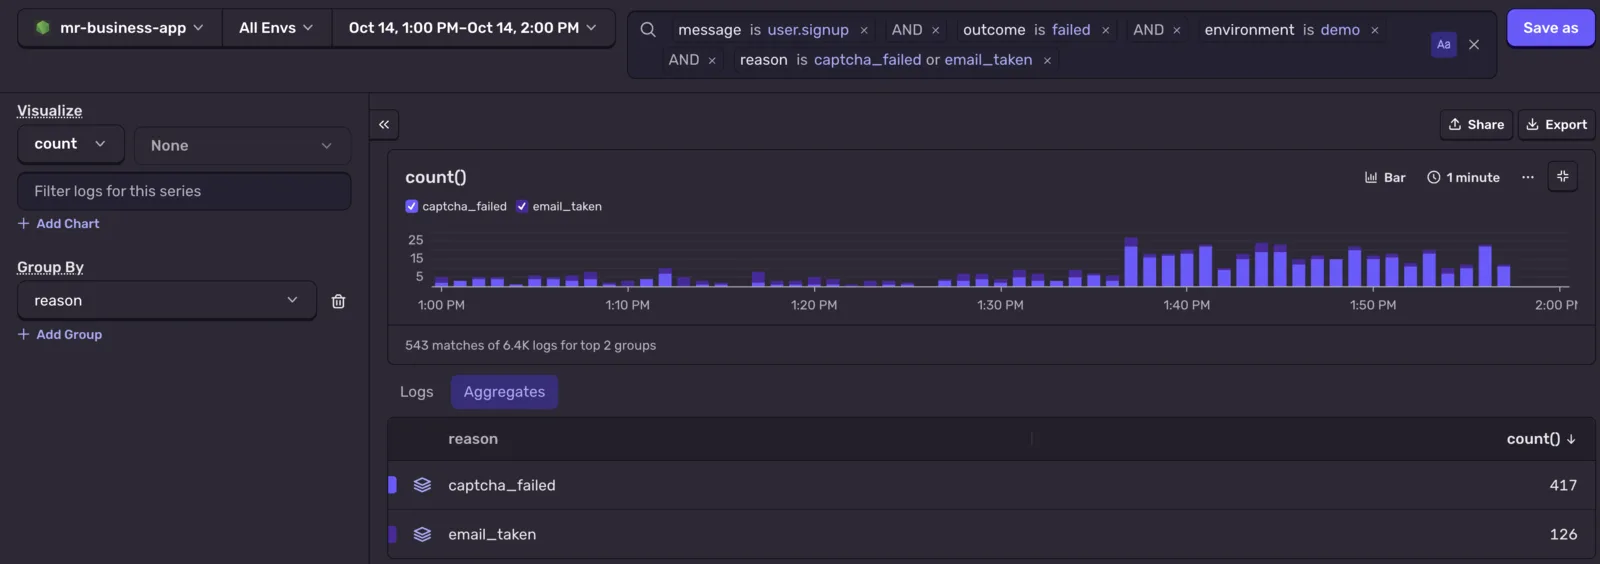
では、失敗したサインアップもメトリクスにすべきでしょうか。それは件数そのものよりも、その上に何を構築するかによります。
メトリクスの役割
ここまでの2つの問いは、どちらも何かがうまくいかない、少なくとも様子がおかしいところから始まっています。
ログは保険です。コードの分岐点でログを書いておけば、後になって誰かに何が起きたのかと聞かれたとき、自分(またはエージェント)が状況を再現できます。ほとんどのログは読まれることがありませんが、それで構いません。分岐点で何を書くべきか、何を省くべきかについては、Ben Coeの
いつ、何をログに残すべきか?が参考になります。
そのため、ログは変更しやすいものでもあります。新機能やエッジケースを観察するために一時的に追加し、次のリリースで削除するものも少なくありません。メッセージはコードレビューで書き換えられますし、コスト削減のためにレベルごと送信をやめることもあります。デバッグしている間は、どれも問題になりません。しかし、ダッシュボードがそのログをカウントしている場合は大問題です。本番環境では info ログを送る価値がないと誰かが判断すれば、それをもとに作ったグラフはすべて止まってしまいます。
メトリクスは、あらかじめ決めておく問いです。何も問題がないときでも、意図して答えを見に行きます。メトリクスに名前を付けることは、ひとつのコミットメントです。その上にダッシュボードやアラートが構築され、誰も気まぐれに名前を変えたりせず、ログのフィルタリングの影響も受けません。
ですから失敗したサインアップについては、失敗率がチームで注視している数値なのであれば、同じ user.signup Counterと outcome: "failed" を使ってカウントもしておきましょう。
メトリクスにすべき問い
サインアップ数は増えているか
これは先ほど後回しにした問いで、すべてのサインアップを通した傾向に関するものです。
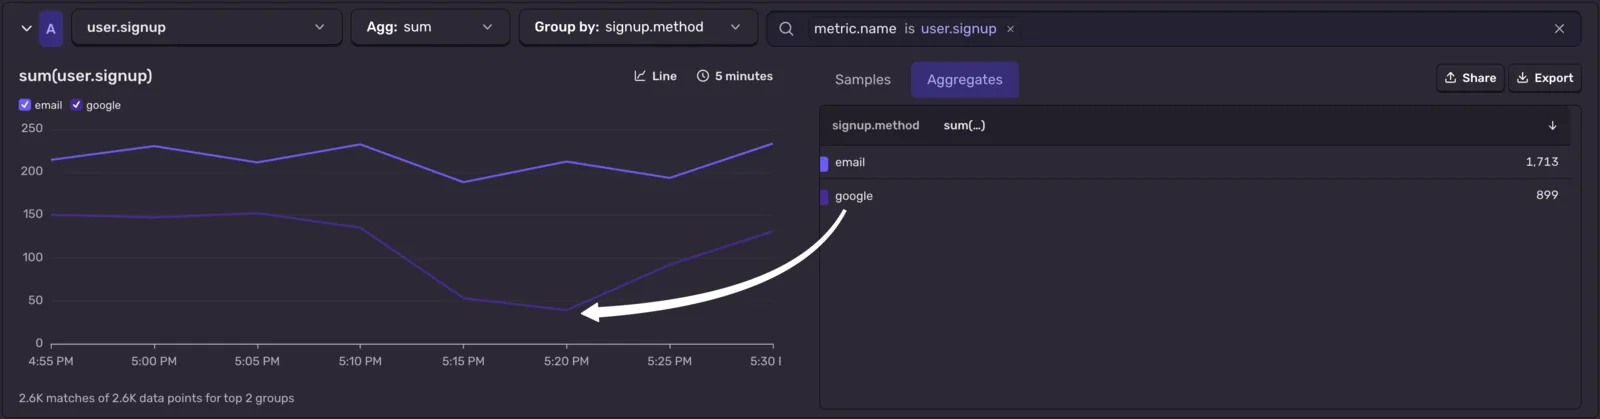
まさにこれが user.signup Counterの役割です。ログと同じスコープ属性を引き継ぐので、追加作業なしで plan や signup.method 別に分析できます。signup.method でグループ化すれば、ユーザーがどの方法でサインアップしているか、そして落ち込みが全体に起きているのか特定の方法だけなのかがわかります。
その落ち込みがリリースのタイミングと一致しているなら、その時間帯の失敗したサインアップのログを確認しましょう。
新規サインアップはどこで離脱しているのか
サインアップはファネルの始まりであって、終わりではありません。たとえば、メールでサインアップしてから最初のプロジェクトを作成するまでに至るユーザー数について、重要業績評価指標(KPI)があるとします。

各ステップはそれぞれCounterで、発生した場所で送出されます。それらの場所は別々のサービスかもしれませんし、ステップの間が何日も空くこともあります。そのため、誰かが確認リンクをクリックする頃には、サインアップ時のスコープはとっくに消えています。グループ化に使いたい属性は、各ステップで改めて渡しましょう。
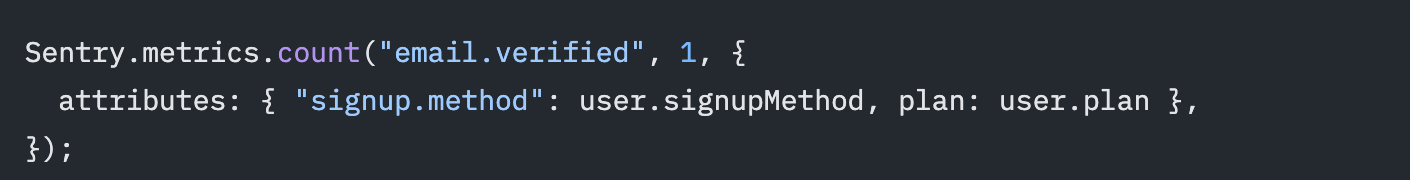
3つのCounterを並べてグラフにすれば、ファネル全体を1ステップずつ確認できます。
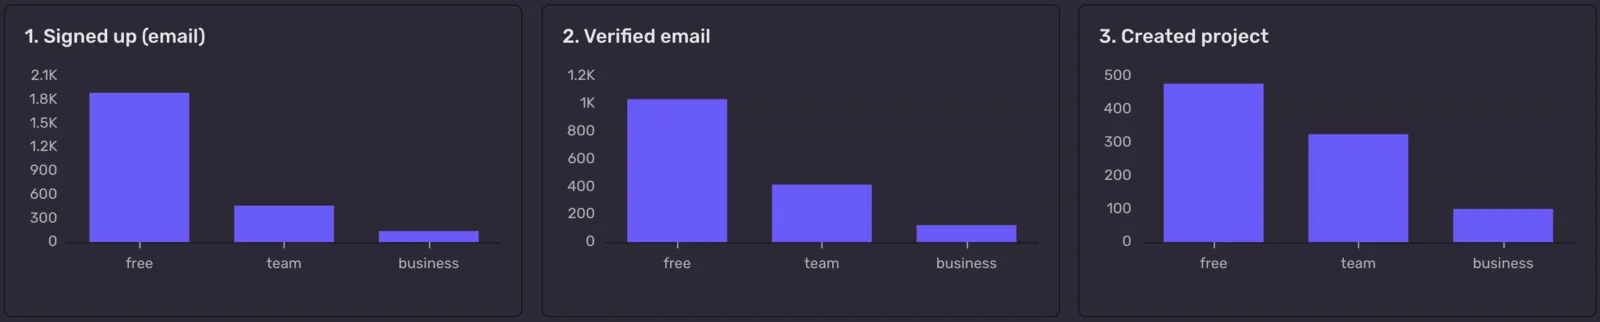
各ステップを plan でグループ化すると、有料プランでサインアップしたユーザーはほぼ全員がメール確認を済ませている一方、無料プランのユーザーはそうではない、といったことがわかるかもしれません。これはバグではありません。エラーも遅延も起きておらず、単に戻ってこなかったユーザーについてログが書かれることもありません。これはプロダクトに関する問いであり、自分から問うと決めなければ見えてこないものです。
代わりにリリースでグループ化すれば、再びエンジニアリングの問いになります。サインアップフォームの変更が、確認ステップに悪影響を与えたのではないか、という問いです。
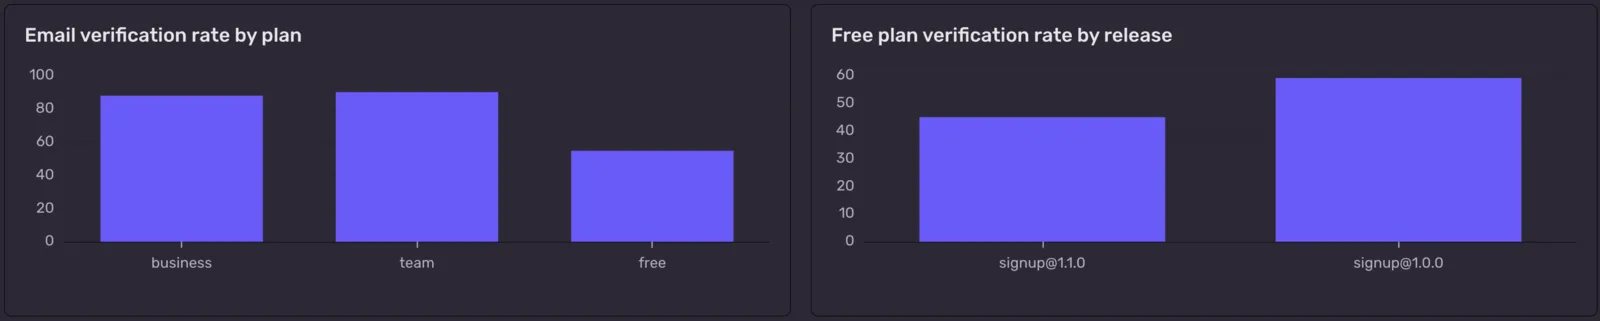
メトリクスでは、1人のユーザーがこれらのステップをたどる様子を追ったり、コホートを作ったり、リテンションを把握したりすることはできません。それはプロダクト分析ツールの役割です。しかし「このステップは悪化しているか?」という問いであれば、ファネルをリリース、エラー、トレースと並べて見られるので、手軽に確かめられます。
メールキューが詰まっていないか
ここまでのメトリクスはすべてCounterでした。何かが起きたら1を加算するものです。Sentryにはほかに2種類のメトリクスタイプがあり、それぞれ異なる形の問いに答えます。
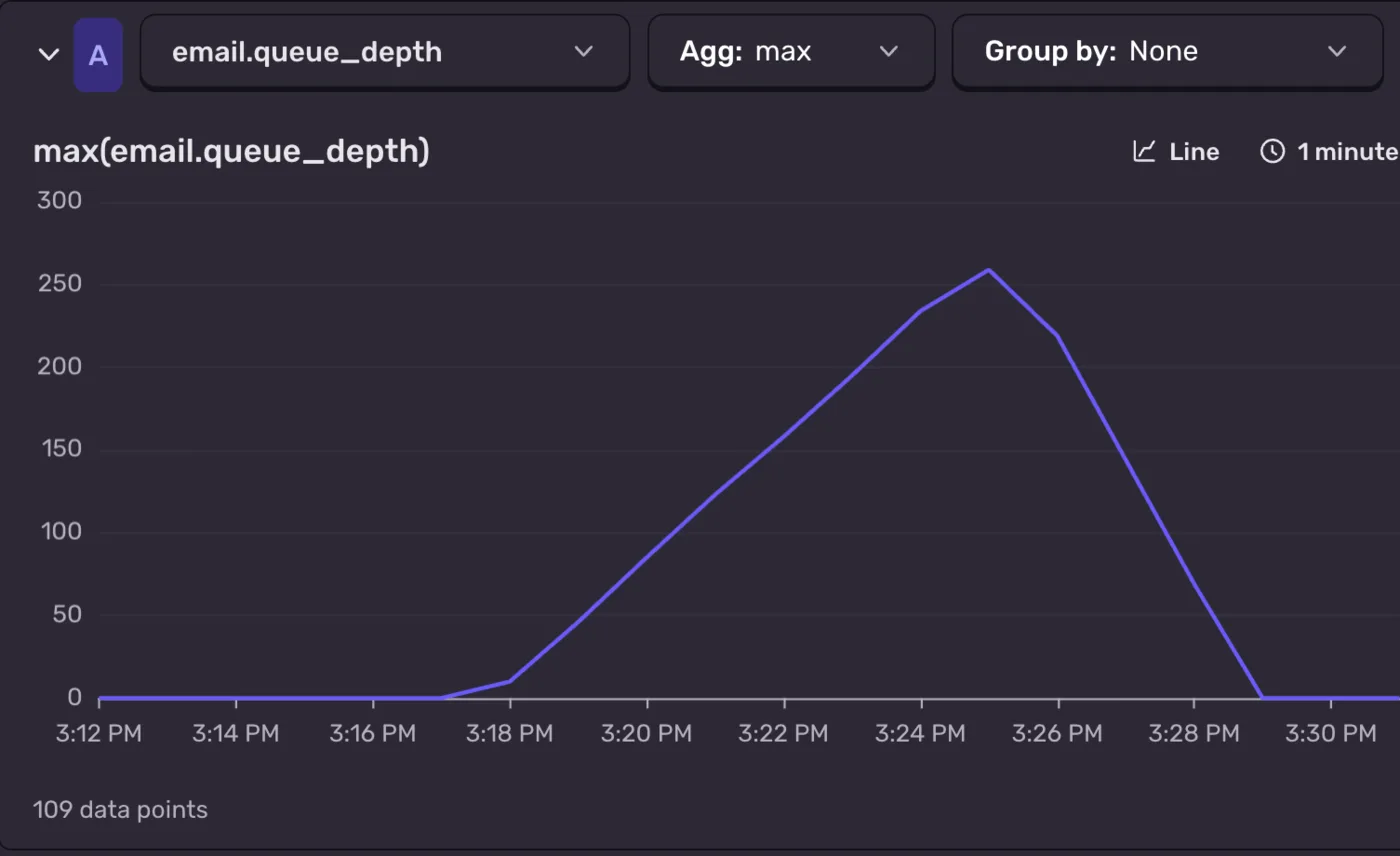
Gaugeはキューの深さやオープンしている接続数など、現時点の値を記録します。イベントをカウントするのではなく水準をサンプリングしているので、サンプルを合計しても意味はありません。知りたいのは、どこまで高くなったか、平均してどのあたりにあったかです。タイマーで、あるいはメールワーカーがキューをチェックするたびに送出しましょう。
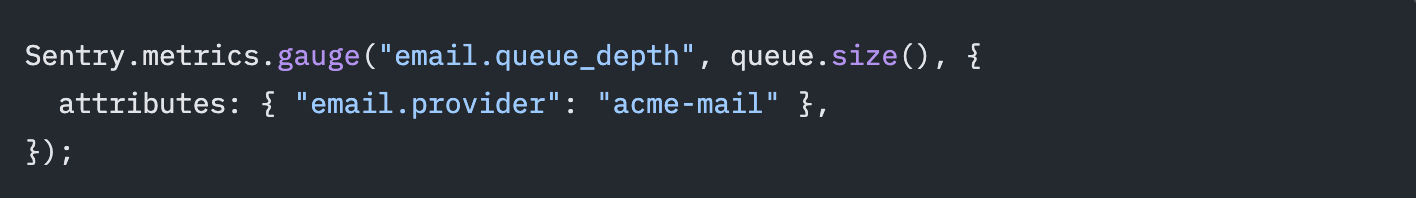
確認メールが保留され始めた場合、キューが増えていく様子を見れば、次の「確認メールが届きません」という問い合わせが来る前に気づけます。
メール確認にどのくらいの時間がかかるのか
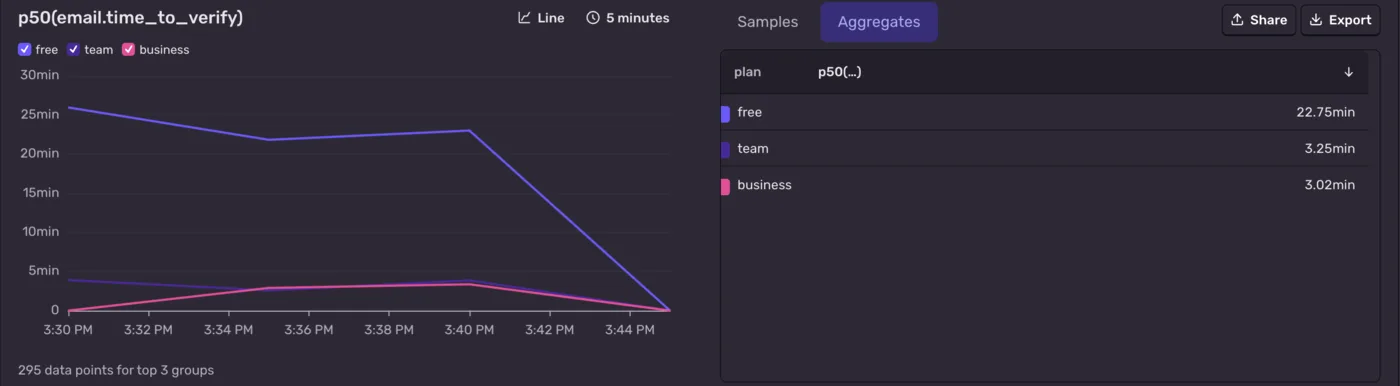
Distributionは「どれくらいの量か」を単位付きで記録し、値のばらつきを保持するので、平均値やパーセンタイルをグラフにできます。リクエスト内で計測するものであれば、トレースですでにそれがわかります。Distributionが役立つのは、トレースでは計測できない値です。たとえば、サイズや、ファイルサイズの推定が最大83%ずれていたことを突き止めたような比率、あるいは何日も離れた2つのリクエスト間の間隔などです。ユーザーがメール確認にかかる時間もその1つです。
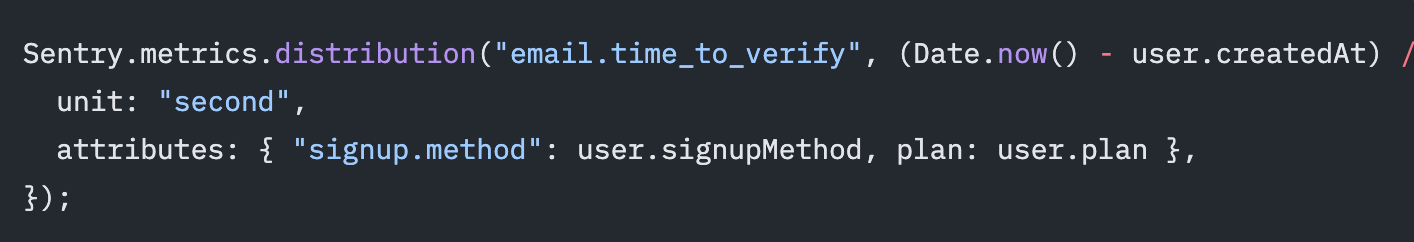
email.verified Counterと同じ場所で、同じ属性を付けて送出しましょう。プランでグループ化すると、中央値では有料ユーザーは約3分、無料ユーザーは約23分で確認しています。p95では、無料ユーザーは2時間近くかかっています。時間の計測が1つのリクエストで始まり、別のリクエストで終わるので、トレースではこれを示すことはできません。
ログとメトリクスの選び方
何かをインストルメントするときは、どのような種類の問いに答えようとしているのかを考えましょう。
| 自問すること |
種類 |
使うもの |
サインアップの例では |
| これが起きたとき、どのような状態だったか。 |
状態 |
ログ |
このサインアップはなぜ失敗したのか。 |
| どのように使われているか、期待どおりに動いているかについて何を知りたいか。 |
自分で選んだ問い |
メトリクス |
サインアップ数は増えているか。 |
状態は、コードが判断を下す時点でログに記録しましょう。メトリクスには、問いとして読めるような名前を付けましょう。
簡単な見分け方があります。すでにログに出力しているものをデバッグ中にカウントしたいなら、ログをカウントしましょう。継続的に追っていく数値なら、メトリクスにしましょう。
だからといって、後でカウントするためにすべてをログに記録すべきという意味ではありません。メトリクスとして直接送出できたはずの数値を算出するために、すべてのイベントの保存コストを払うことになるからです。カウントするのは、デバッグ用にどのみち送信しているログにとどめましょう。
Sentryに送るべきもの
すでに別の場所にログやメトリクスを送っているかもしれません。そのすべてを移行する必要はありませんし、同じデータを二重に保存するためにお金を払うべきでもありません。
アクセスログ、インフラやプラットフォームのログ、コンプライアンス用のアーカイブ、CPUやメモリのグラフ、デバッグレベルの細かな出力は、今ある場所に置いたままにしましょう。これらはデータ量が多く、スタックトレースと並べて見る必要はめったにありません。
Sentryには、失敗したサインアップや保留された確認メールのように、デバッグ時に参照するアプリケーションログと、自分で選んだ問いに答える少数のメトリクスを送りましょう。Sentryでは、これらがエラー、トレース、変更を加えたリリースと並んで表示されます。問題が発生したとき、自分(またはエージェント)は、ツールを切り替えたりタイムスタンプを突き合わせたりすることなく、スタックトレースからその瞬間にコードが何をしていたかまでたどれます。
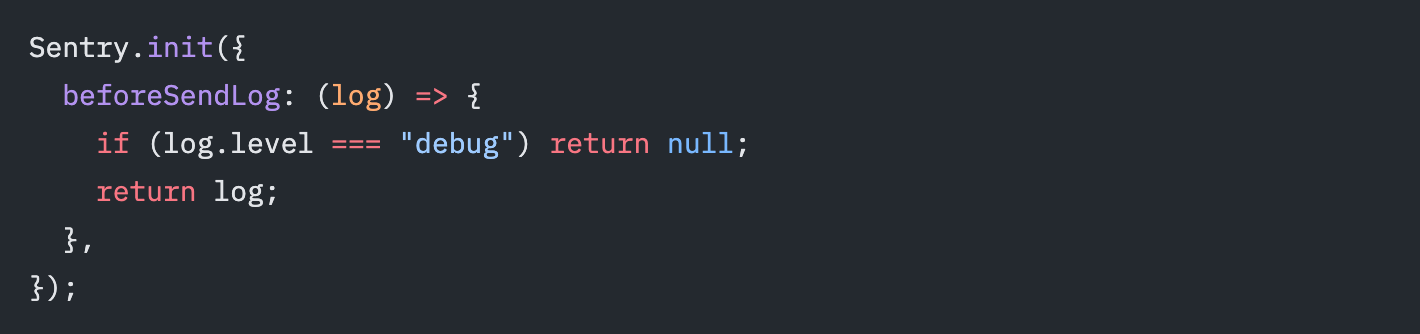
この線引きは、アプリから何かが送信される前に、SDK内で行うことができます。beforeSendLogはすべてのログを確認し、null を返すことでログを破棄できます。
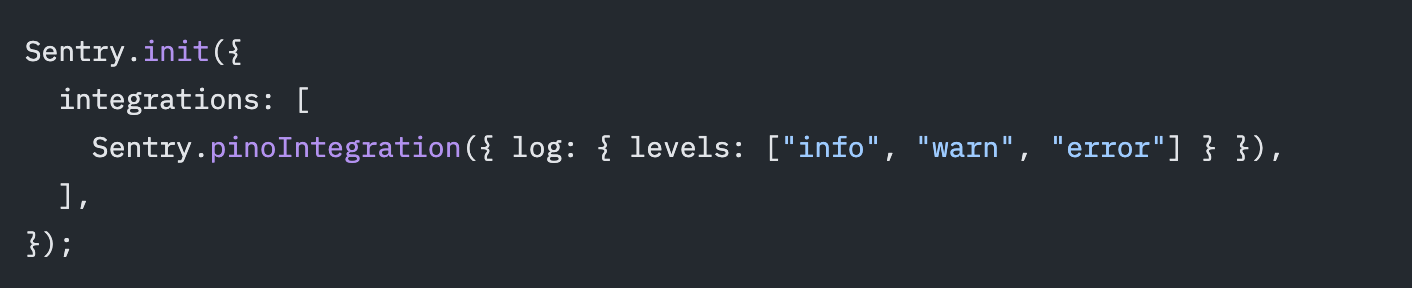
すでにPinoや console でログを出力している場合、インテグレーションでレベルのリストを指定できます。デバッグに使うレベルをSentryに転送し、それ以外はこれまでどおりの送信先に送り続けられます。
ベストプラクティス例
- 両方で同じ名前と同じ属性キーを使う —
user.signup がログとCounterの両方にあれば、一方で急増を見つけたフィルターで、もう一方からその背後にある行を見つけられます。
- 送信するものは意図して選ぶ — 実際に見る少数のメトリクスと、デバッグするコードのログに絞りましょう。それぞれに意味を持たせるべきなので、後で必要になるかもしれないというだけで追跡するのはやめましょう。
- ユーザーと共有属性は冒頭で一度だけ設定する —
setUser() とスコープ属性を使えば、毎回同じキーを繰り返さなくても、リクエスト内のすべてのログとメトリクスの一貫性が保たれます。
setUser() で何を送るかを決めておく — 通常は、照会できるIDがあれば十分です。意図して収集するのでない限り、メールアドレスは含めないようにしましょう。詳しくはScrubbing Sensitive Dataをご覧ください。- GaugeとDistributionには単位を付ける — Sentryは単位を使って値を表示・変換するので、秒単位の時間がただの数値としてグラフ化されることがなくなります。
- スパンだけにしかないデータを作らない — スパンはタイミングの計測に最適ですが、サンプリングもされます。
SentryでLogsとMetricsを始める
ログとメトリクスはどちらもSentry SDKに含まれており、ほかのあらゆるデータとつながっています。メトリクスが変動したら、同じリクエストのログにはフィルター1つでたどり着け、そこからワンクリックでトレースやエラーを確認できます。
Developer、Team、Businessプランには、毎月5GBのログと5GBのApplication Metricsが含まれます。TeamとBusinessでは、いずれも超過分は$0.50/GBです。詳細はLogsとApplication Metricsのchangelogを、セットアップ方法はログとメトリクスのドキュメントをご覧ください。
SDK v10.71.0以降では、ログはデフォルトで有効です。それより前のバージョンでは、Sentry.init で enableLogs: true を設定してください。
セットアップはエージェントに任せる
Sentry agent pluginは、Claude Code、Cursor、Codex、Grokで動作します。

あとは、同じパターンをコードに適用するよう依頼しましょう。
Sentryのログとメトリクスを追加する
(英語)
Add Sentry logs and metrics to my signup handler.
Look at my existing logging and tell me which of these should be metrics.
Only send info, warn, and error logs to Sentry in production.
(日本語)
サインアップハンドラーにSentryのログとメトリクスを追加してください。
既存のログ出力を確認し、どれをメトリクスにすべきか教えてください。
本番環境では、info、warn、errorのログのみをSentryに送信してください。
FAQ
■ ログの行数をカウントするだけではだめですか?
すでにログに出力しているものなら、それで問題ありません。Logsエクスプローラーでは任意のログクエリをカウント、グループ化、グラフ化でき、それをもとにダッシュボードウィジェットやアラートを作成できます。問いがデバッグに関するものではない場合や、継続的に追う数値で送信するログを変えてもカウントを続ける必要がある場合は、メトリクスを使いましょう。
■ Sentryにはどのような種類のメトリクスを送れますか?
3種類あります。Counter(Sentry.metrics.count)は、サインアップのように何かが起きた回数をカウントします。Gauge(Sentry.metrics.gauge)は、キューの深さのようにある時点の値を記録し、最小値、最大値、平均値としてグラフ化されます。Distribution(Sentry.metrics.distribution)は、メール確認にかかる時間やファイルサイズのように「どのくらいの量か」を記録し、パーセンタイルとしてグラフ化されます。Sentryが値を正しく表示できるよう、GaugeとDistributionには単位を付けましょう。
■ すでに別の場所にログを送っています。Sentryにも送るべきですか?
すべてを移行する必要はありません。アクセスログ、インフラのログ、コンプライアンス用のアーカイブは、今ある場所に置いたままにしましょう。Sentryには、デバッグ時に参照するアプリケーションログを送ってください。Sentryではすべてのログが、記録されたトレースに紐づいているので、エラーが発生したときには、それを説明するログがすでに添付されています。
■ コストはどのくらいかかりますか?
Developer、Team、Businessプランには、毎月5GBのログと5GBのApplication Metricsが含まれます。TeamとBusinessでは、いずれも超過分は$0.50/GBです。詳しくはSentryの料金をご覧ください。
■ コストを抑えるにはどうすればいいですか?
beforeSendLogを使ってSDK内でフィルタリングし、既存のロガーからはデバッグに使うレベルだけを転送しましょう。(例:Pinoインテグレーション)メトリクスは、実際に確認する問いに絞りましょう。
■ 名前はどのように付けるべきですか?
シグナルではなく、イベントに名前を付けましょう。signup_log や signup_count ではなく、ログとCounterの両方に user.signup を使い、signup.method や plan などの属性キーも両方で同じにします。そうすれば、メトリクスの急増を見つけたフィルターで、その背後にあるログも見つけられます。名前は変えずに固定し、変化するものはすべて属性に入れて、名前そのものには含めないようにしましょう。ログを構造化する方法では、安定したイベント名とスコープ付きの属性キーについて、リンターで強制する方法も含めて詳しく解説しています。
■ 個人を特定できる情報(PII)はどう扱えばいいですか?
setUser()と共有属性で何を送るかを決めておきましょう。これらはすべてのログとメトリクスに含まれるからです。通常は、照会できるIDがあれば十分です。フィルタリングと beforeSend* フックについては、Scrubbing Sensitive Dataをご覧ください。
Original Page: Should you use a log or a metric?
IchizokuはSentryと提携し、日本でSentry製品の導入支援、テクニカルサポート、ベストプラクティスの共有を行なっています。Ichizokuが提供するSentryの日本語サイトについてはこちらをご覧ください。またご導入についての相談は「お問い合わせ」からお気軽にお問い合わせください。
日本語ブログホームへ戻る